
Antonie Březinová, 2025
Abstrakt
Tato práce zkoumá, jak studenti vyhledávají akademické informace, se zaměřením na srovnání Google Scholar a tradičních knihovních databází. Popisuje rozdíly v dostupnosti, rozsahu pokrytí, vyhledávacích funkcích a citačních nástrojích těchto platforem. Na základě existujících studií a modelů uživatelského chování práce poukazuje na aktuální trendy ve vyhledávání vědeckých informací a diskutuje jejich dopady na vysoké školy a knihovny.
Klíčová slova
Google Scholar, knihovní databáze, akademické vyhledávání, informační gramotnost, studenti, uživatelské preference, výsledky vyhledávání
Úvod
Studentské seminární práce i způsoby, kterými jsou psány, prošly za posledních padesát let výraznou proměnou. Informace jsou dnes nesrovnatelně dostupnější a množství zdrojů, z nichž lze čerpat, narostlo exponenciálně. Studenti tak mají při rešerši k dispozici nepřeberné množství materiálů. K „tradičním“ zdrojům, jakými jsou bezpochyby knihovní databáze, přibyl v poslední dekádě také Google Scholar, uživatelsky přívětivý a jednoduše přístupný nástroj, který se stal běžnou součástí akademického prostředí.
Narůstající popularita Google Scholar přináší spoustu otázek, např. jak se mění trendy ve vyhledávání akademických informací, jak rozvoj obou nástrojů ovlivňuje studentské preference, nebo jakou roli dnes mají knihovní databáze v porovnání právě s Google Scholar.
Cílem této práce je přinést přehled současných trendů ve využívání knihovních databází a Google Scholar, provést komparaci jejich hlavních vlastností a doplnit ji o vlastní zkušenosti s jejich používáním. Práce se zaměřuje na klíčové faktory hrající hlavní roli při rozhodování studentů a snaží se objasnit, jak jednotlivé nástroje odpovídají studentským preferencím a v jakých konkrétních situacích jsou nejčastěji využívány.
Využívá komparativní analýzu dostupné odborné literatury a vlastních pozorování při práci s oběma platformami. Při přípravě této seminární práce byla využita generativní AI jako podpůrný prostředek pro návrh struktury, formulaci textu a jazykové úpravy. Veškerý obsah, interpretace a finální podoba textu jsou mým vlastním tvůrčím výstupem.
Výzkumné otázky:
1. Jaké jsou hlavní rozdíly mezi Google Scholar a knihovními databázemi?
2. Jaké faktory ovlivňují výběr nástroje studenty při vyhledávání vědeckých informací?
3. Jak roste či klesá význam tradičních knihovních databází v éře snadno dostupných vyhledávačů?
1 Charakteristika porovnávaných nástrojů
Tato kapitola slouží k představení nástrojů, které jsou hlavním předmětem následné komparace v analytické části práce, tj. Google Scholar a knihovní databáze. Popsány jsou jejich základní principy, práce s citacemi a nastíněny jsou také jejich uživatelské vlastnosti a způsoby, kterými předávají vědecké informace.
1.1 Google Scholar
Google Scholar (dále GS) je volně dostupný vyhledávač vědecké literatury, který společnost Google uvedla v roce 2004 jako způsob, jak zjednodušit přístup k odborným zdrojům napříč obory. Podle Howlanda a spol. (2009) byl GS od počátku navržen tak, aby uživatelům umožnil vyhledávání napříč širokým spektrem dokumentů, včetně recenzovaných článků, knih, konferenčních příspěvků či disertací. Jeho hlavní výhodou je především dostupnost a jednoduché a intuitivní uživatelské rozhraní, což z něj činí často první volbu studentů při vyhledávání vědeckých informací pro rešerši.
1.1.1 Princip Google Scholar
GS je založen převážně na automatizovaném procházení a indexaci veřejně dostupných webových zdrojů nebo digitálních archivů prostřednictvím vyhledávacích robotů (web crawlers). Haddaway a spol. (2015) explicitně uvádějí, že podobné vyhledávače „necílí na konkrétní databázi, ale pravidelně ‚crawlují‘ internet a indexují dokumenty, které vypadají jako vědecké citace“ (doslova: „they regularly ‚crawl‘ the internet for information that appears to be a citation“).
Na rozdíl od tradičních knihovních databází, které pracují s kurátorským výběrem obsahu, GS indexuje materiály na základě struktury jejich metadat a dostupnosti. Tento princip indexování sice umožňuje rozsáhlé pokrytí zdrojů, na druhou stranu je ovšem spojen s omezenou transparentností a nekonzistentní kvalitou metadat. Tento problém popisuje například Jacsó (2005), který upozorňuje na chyby v metadatech způsobené automatizovaným zpracováním, které často generuje duplicity.
Podle Haddaway a spol. (2015) je navíc proces indexace zcela netransparentní, tzn. neexistuje veřejný pevně daný seznam časopisů či vydavatelů. Autoři ve svých případových studiích ukazují, že při použití identických dotazů může GS vracet mírně odlišný počet záznamů a jejich pořadí se v čase mění, což prakticky znemožňuje jakoukoliv reprodukovatelnost systematických rešerší.
Vyhledávání v GS probíhá stejně jednoduše jako v klasickém vyhledávači Google. Podobně jako Google vyhledávač, ani GS nevyžaduje přesné zadání klíčových slov a dokáže pracovat i s jinými variantami. Jacsó (2005) upřesňuje, že GS dokáže vracet výsledky i u vágně formulovaných dotazů a zahrnuje také morfologické varianty i tematicky příbuzné pojmy klíčových slov.
Z hlediska pokročilejších rešerší je ovšem důležitá i opačná strana mince, podle Haddaway a spol. (2015) GS povoluje pouze omezenou Booleovskou logiku, délka dotazu je limitována na 256 znaků a výsledky lze zobrazit maximálně do 1000 záznamů, a to bez možnosti změnit způsob řazení (např. podle data). Gusenbauer a Haddaway (2020) proto řadí GS mezi „efficient-slick“ systémy čili velmi pohodlné nástroje pro rychlé vyhledávání, ale zcela nevhodné jako samostatný nástroj pro reprodukovatelné vyhledávání.
Dalším specifikem GS je široká škála dostupných dokumentových typů sahající od klasických recenzovaných článků až po monografie, kapitoly v knihách či různé zprávy a pracovní dokumenty, tedy velké množství šedé literatury. Případové studie Haddaway a spol. (2015) ukazují, že podíl šedé literatury může tvořit u vyhledávání podle názvu i více než 40 % výsledků. Většina se objevuje až na pozdějších stránkách vyhledávání (často 20. až 30.) a uživatel, který zkontroluje jen prvních pár stránek tak o velkou část těchto zdrojů přijde.
1.1.2 Práce s citacemi v Google Scholar
GS automaticky generuje citační údaje k indexovaným dokumentům. U každého výsledku se zobrazuje funkce Cited by, která uvádí počet publikací nebo textů odkazujících na daný dokument. Tyto údaje poskytují uživateli rychlou a na první pohled jednoduše interpretovatelnou informaci o citační relevanci zdroje a umožňují tzv. „citation chasing“ – tedy dohledávání dalších souvisejících článků přes seznam citujících dokumentů.
Jacsó (2005) na druhou stranu zmiňuje, že citační údaje v GS mohou být nepřesné, konkrétně nadsazené, protože automatizovaný indexační proces často generuje duplicitní záznamy nebo nesprávně spárovaná metadata. Haddaway a spol. (2015) ve své analýze uvádí, že míra duplicit v GS se v jejich případových studiích pohybovala kolem 1–5 % všech výsledků, přičemž duplicity vznikají převážně kvůli rozdílnému formátování titulu, skenování PDF nebo tomu, že GS zvlášť indexuje citaci v seznamu literatury a zvlášť původní článek.
Houshyar a Sotudeh (2018) navíc doplňují, že odhady GS ohledně počtu zobrazených výsledků jsou nekonzistentní a nespolehlivé, navíc se tyto odhady můžou měnit i při opakovaném zadání totožného dotazu. Na druhou stranu, Haddaway a spol. (2015) ukazují, že pokud student či výzkumník hledá konkrétní, již známý článek, GS ho ve většině případů dokáže dohledat, a to často i s přímým odkazem na volně dostupnou verzi. GS je tak velmi užitečný pro rychlé dohledání jednotlivých citací a pro rozšíření rešerše o šedou literaturu, nikoli však jako jediný zdroj pro systematické přehledové studie.
1.2 Knihovní databáze
Mezi nejznámější knihovní databáze patří například Web of Science, Scopus nebo EBSCO. Regis College Library (bez data) popisuje knihovní databázi jako kurátorsky sestavenou kolekci zdrojů, která zahrnuje vědecké články, knihy, časopisy a další materiály, které knihovníci a odborní pracovníci pečlivě vybírají a organizují. Jedná se zkrátka o kvalitní zdroj informací, který při psaní odborných textů tvoří spolehlivou oporu.
Před nástupem GS představovaly knihovní databáze jeden z mála přímých zdrojů, kde bylo možné systematicky vyhledávat vědecké články a další akademické zdroje. Mezi jejich nesporné výhody patří detailně označené záznamy vhodné pro vyhledávání bez většího rizika chybovosti. Gusenbauer a Haddaway (2020) v rozsáhlém srovnání 28 akademických vyhledávacích systémů popisují, že právě tyto tradiční bibliografické databáze (např. Web of Science, Scopus) nejlépe splňují nároky na transparentní, reprodukovatelné a systematické vyhledávání.
I přes vysokou kvalitu a dobrou reprodukovatelnost vyhledávání může být práce s nimi pro některé studenty obtížnější, protože jsou méně intuitivní nebo uživatelsky přátelské než běžné internetové vyhledávače.
1.2.1 Princip knihovních databází
Knihovní databáze pracují na základě odborně vytvářených metadat a kontrolovaných slovníků (např. subject headings, thesauri), které zaručují přesnou kategorizaci a třídění obsahu. Howland a spol. (2009) uvádějí, že knihovní databáze umožňují detailní filtrování podle autora, názvu, tématu či data, což je zásadní rozdíl oproti GS.
Na rozdíl od GS, kde je indexování dokumentu výsledkem automatického procházení webu, knihovní databáze často pracují s předem definovanými časopisy a vydavateli. Záznamy jsou do databáze vkládány na základě spolupráce s vydavateli a jsou podrobeny odborné kontrole. Díky kurátorské indexaci je možno výsledky vyhledávání reprodukovat, stejný dotaz tak vrací stejný soubor dokumentů, dokud nedojde k aktualizaci obsahu (Gusenbauer a Haddaway, 2020).
1.2.2 Práce s citacemi v knihovních databázích
Práce s citacemi v knihovních databázích je založená na odborně vytvářených metadatech, která pocházejí přímo od vydavatelů či z kurátorsky spravovaných indexů. Díky tomu obsahuje každý záznam přesně uvedené bibliografické údaje, které jsou doplňovány podle jednotných pravidel přímo vydavateli nebo knihovníky (Arendt, 2008). Knihovní databáze poskytují spolehlivé bibliografické informace právě díky tomu, že záznamy procházejí odbornou kontrolou a jsou vytvářeny pomocí standardizovaných metadat, mezi něž spadají např. názvy časopisů, jméno autora, rok vydání, klíčová slova nebo DOI.
Další nespornou výhodou knihovních databází je nabídka různých funkcí pro sledování citačních vazeb mezi dokumenty. Databáze jako např. Web of Science nebo Scopus umožňují zobrazení seznamu prací, které na daný článek navazují nebo ho citují, či naopak přechod k článkům, na které daný dokument odkazuje. Záznamy lze také exportovat v různé struktuře do citačních manažerů. Podle Howlanda a spol. (2009) je tato strukturovanost velkou výhodou při odborné práci.
Díky těmto nástrojům jsou knihovní databáze vhodné nejen pro rychlé dohledání konkrétního článku, ale i pro tvorbu uceleného soupisu odborné literatury.
2 Komparace Google Scholar a knihovních databází
2.1 Přístupnost a dostupnost
Přístupnost a dostupnost představují jeden z klíčových faktorů, které ovlivňují volbu nástroje pro vyhledávání informací pro výzkum. GS je z tohoto hlediska extrémně vstřícný, a to zejména díky své dostupnosti všem uživatelům s připojením k internetu, čímž snižuje bariéry vstupu do akademického vyhledávání – k základní rešerši uživatel nepotřebuje znalost konkrétních databází, ani institucionální licenci.
Jeho přístupnost spočívá zejména ve známém uživatelském rozhraní připomínajícím běžný Google vyhledávač (Howland a spol., 2009), díky čemuž je vhodný i pro méně zkušené uživatele. Další výhodou je široké pokrytí zdrojů – Haddaway a spol. (2015) uvádějí, že Google Scholar shromažďuje dokumenty z celého internetu a katalogizuje mezi 2 až 100 miliony záznamy, což uživateli poskytuje široký přístup k vědeckým i šedým materiálům.
Naopak knihovní databáze jsou ve srovnání s GS dostupné podstatně méně. Arendt (2008) upozorňuje na poplatky za přístupnost a jejich používání je proto často omezeno na instituce, které si mohou předplatné dovolit (např. vysoké školy, univerzity, či výzkumné ústavy). Obsah, který nabízejí, je vybíraný podle indexů určených kurátory či autory (Haddaway a spol., 2015), což zajišťuje vysokou kvalitu, ale zároveň omezuje veřejný přístup. V důsledku toho jsou knihovní databáze přístupné zejména studentům a pracovníkům vybraných univerzit, zatímco GS zůstává otevřeným nástrojem pro širokou veřejnost.
2.2 Kvalita a přesnost výsledků vyhledávání
U GS bývá často vyzdvihováno rozsáhlé pokrytí zdrojů s možností poskytnout uživateli velké množství vyhledaných záznamů, nicméně v tomto případě je zde kvantita výsledků na úkor kvality. Jacsó (2005) upozorňuje, že v GS dochází k častým nesrovnalostem ve vyhledávaných údajích, neboť systém spoléhá na plně automatizované parsování dokumentů. Tyto vlastnosti mohou vést k tomu, že výsledky nejsou vždy jednotlivě interpretovatelné a opakovatelné a uživatel je nucen část nepřesností manuálně opravovat.
Podobné závěry přinášejí i novější studie. Houshyar a Sotudeh (2018) prokázali, že GS vrací významný podíl nerelevantních nebo obtížně interpretovatelných výsledků, a to včetně záznamů, které neobsahují hledaný termín ani v názvu, ani v abstraktu. Přesnost vyhledávání je omezena zejména v případě obecných nebo víceznačných dotazů. Haddaway a spol. (2015) tuto myšlenku v o 10 let novější studii potvrzují, v jejich případových studiích GS běžně generoval duplicitní výsledky, výsledky s chybnými či neúplnými bibliografickými údaji nebo výsledky odkazující na šedou literaturu různorodé kvality.
Na druhou stranu, studie ukázaly, že knihovní databáze mají v oborech jako např. umění, humanitní studia, informační technologie a sociální studia, výrazně slabší pokrytí než GS. Pravděpodobně je to způsobeno faktem, že GS u těchto oborů ukazuje vyšší počet citačních záznamů právě kvůli šedé literatuře mimo ověřené bibliografické databáze (Levine-Clark a Gil, 2021). Kvantita výsledků vyhledávání v GS tedy může být v určitých oblastech výhodou, a to převážně tam, kde knihovní databáze selhávají kvůli omezenému seznamu indexované literatury.
Haddaway a spol. (2015) navíc ukazují, že při porovnání výsledků vyhledávání v GS a Web of Science dochází jen k částečné shodě – GS sice často najde více záznamů, ale významnou část záznamů z tradičních databází nezobrazí vůbec (např. kvůli limitu 1000 výsledků či odlišnému řazení). Lze tedy konstatovat, že GS poskytuje vysoké pokrytí výsledků, přesná kontrola vygenerovaného obsahu je však omezená.
Knihovní databáze na druhou stranu nabízejí kvalitu, nikoliv kvantitu. Arendt (2008) zdůrazňuje, že tradiční databáze využívají metadata přímo od autorů, což výrazně zvyšuje přesnost bibliografických údajů a snižuje výskyt chyb. Howland a spol. (2009) dodávají, že tyto databáze umožňují detailní filtrování výsledků podle přesně strukturovaných polí, což je zásadní pro vysoce kvalitní přesně cílené vyhledávání. Výsledky jsou tak reprodukovatelné a spolehlivé, protože stojí na kurátorsky spravovaných zdrojích s jasně definovanými bibliografickými pravidly.
2.3 Limity obou nástrojů
Přestože oba nástroje nabízejí různé výhody, jejich využití v odborné práci je omezeno také celou řadou slabin, které mohou ovlivnit průběh rešerše. Jedním z největších problémů GS je již zmíněná nízká transparentnost. I když GS disponuje oproti knihovním databázím podstatným množstvím šedé literatury, kvalita těchto materiálů může být velmi různorodá, což může komplikovat určení akademické hodnoty a relevance (Howland a spol., 2009).
Knihovní databáze, na druhou stranu, fungují na základě přísnějšího výběru zdrojů. Jejich obsah je, jak bylo zmíněno v kapitole 1.2.1, kurátorsky spravovaný a zahrnuje pouze vybrané časopisy a publikace, které splňují jasně a striktně definované kvalitativní standardy. Tento postup sice zajišťuje vysokou spolehlivost, ale zároveň vede k tomu, že některé typy dokumentů, jako např. knihy nebo lokální periodika, nejsou do databází zařazeny, což může představovat problém zejména u interdisciplinárních oborů nebo oblastí, které se dynamicky rozvíjejí (Haddaway a spol., 2015).
Dalším limitem knihovních databází je jejich závislost na vydavatelích. Arendt (2008) upozorňuje, že rozsah databáze závisí na uzavřených smlouvách s jednotlivými vydavateli, což může způsobit rozdíly v dostupnosti některých titulů a opožděnou indexaci nových čísel časopisů. Obsah databází se navíc neaktualizuje okamžitě po vydání článku, což je rozdíl oproti GS, kde se nové materiály objevují často velmi rychle.
Významným omezením knihovních databází je také již zmíněná dostupnost. Většina z nich je vázána na institucionální předplatné – na tento problém naráží však i GS, který mezi vyhledané výsledky občas zařadí i odkaz na studii či článek nacházející se v knihovní databázi – tudíž mnohdy za „paywallem“. Vysvětlení lze hledat ve způsobu fungování GS. Zaprvé, GS indexuje metadata, nikoliv obsah jako takový, snadno se tak stane, že ze samotného abstraktu „nepřístupné“ studie vyhodnotí GS její relevanci a bez dalšího ověření ji zařadí do výsledků (Howland a spol., 2009). Zadruhé, systém sbírá bibliografické záznamy i z dokumentů, které placené články citují, takže je dokáže zařadit do výsledků bez potřeby přístupu k originálnímu textu (Haddaway a spol., 2015).
3 Faktory ovlivňující volbu nástrojů studenty
Při volbě vhodného vyhledávacího nástroje se jedná o komplexní rozhodnutí, podléhající řadě faktorů – od psychologických, až po ty praktické. Studenti se při výběru neopírají pouze o dostupnost a kvalitu výsledků, ale také berou v potaz místo, kde pracují, své vlastní dovednosti, časovou tíseň nebo obor, který studují. Zatímco předchozí kapitoly se zaměřovaly zejména na technické rozdíly mezi GS a knihovními databázemi, tato část se soustředí převážně na praktické otázky, proč si studenti vybírají jeden nebo druhý nástroj a co jejich výběr skutečně ovlivňuje.
3.1 Psychologické a praktické faktory
Studentskými preferencemi se ve své studii podrobně zabývá Colón-Aguirre (2019). Ve své studii popisuje, že pro studenty je zcela zásadní jednoduché ovládání, rychlost vyhledávání a minimum kroků potřebných k získání výsledku. Jak uvádějí Howland a spol. (2009), podobnost GS s klasickým internetovým vyhledávačem snižuje tzv. „cognitive load“, tj. mentální úsilí potřebné k pochopení nástroje. Právě díky tomu je GS první volbou zejména u méně zkušených uživatelů.
Důležitým faktorem je také možnost využívat GS jak na stolním počítači, tak na telefonu či tabletu, což je studenty ve studii Colón-Aguirre (2019) explicitně oceňováno. GS ve stejné studii vyhrává v celkové uživatelské spokojenosti právě díky pohodlnosti a rychlému získání „nějakých“ výsledků.
Naopak významným psychologickým faktorem při upřednostnění knihovních databází je vnímání odbornosti a legitimity. Colón-Aguirre (2019) uvádí, že pokud knihovní databázi doporučí lidé, ke kterým studenti chovají respekt a váží si jejich názoru, jako např. profesoři, vyučující nebo akademicky respektované osoby, pravděpodobnost jejich výběru roste. Knihovní databáze jsou celkově mnohem více doporučované lidmi z akademické sféry než GS, někteří studenti dokonce uvedli, že jejich motivace k upřednostnění knihovních databází je založena na tom, že vedoucí daného kurzu požadoval výhradně použití knihovních databází (Colón-Aguirre, 2019).
Výzkum Gusenbauera a Haddaway (2020) dále ukazuje, že studenti často preferují GS z důvodu komfortu, v praxi to znamená co nejméně nutných kliknutí, méně nastavování a méně učení. Naopak knihovní databáze jsou často voleny tam, kde je motivace silnější, typicky v situacích, jako např. domácí úkoly nebo seminární práce, kdy studenti cítí, že „levnější“ cesta by byla akademicky nedostatečná.
3.2 Informační gramotnost
Jak již bylo zmíněno, GS na své uživatele neklade téměř žádné nároky týkající se informační gramotnosti, celé vyhledávání probíhá v jednom vyhledávacím okně a toleruje také vágní nebo nepřesné dotazy a vrací alespoň částečně relevantní výsledky, dokonce nabízí funkce typu „related articles“, které uživateli nabízí obsah vyhodnocený jako relevantní (Jacsó, 2005).
Knihovní databáze jsou studenty vnímány jako méně přehledné, ale zároveň více komplexní než GS. Colón-Aguirre (2019) upozorňuje, že tento výsledek se liší od starších studií, které naopak popisovaly GS jako chaotický a nepřehledný a ukazuje tak na významný vývoj knihovních databází v posledních dvou dekádách, jejich modernizaci, redesign uživatelského rozhraní a lepší integraci s citačními nástroji.
Na rozdíl od GS kladou knihovní databáze na uživatele vyšší nároky, co se týče informační kompetence, jako např. filtrování, volbu databáze podle oboru, porozumění tomu, co znamená indexace nebo práci s booleovskými operátory (Gusenbauer a Haddaway, 2020).
3.3 Oborová specifika
Vliv na výběr má patrně i studovaný obor a typ vyhledávané literatury. Levine-Clark a Gil (2021) ukazují, že GS poskytuje oproti knihovním databázím výrazně lepší pokrytí v řadě oborů, zejména pak v humanitních a sociálních vědách. V těchto oborech je publikováno více knih a preprintů, které knihovní databáze často neindexují. Naopak u přírodních a technických věd může být výhodnější použití specializovaných databází, protože nabízejí přesnější filtry a konzistentní citační údaje. Výběr nástroje tak není pouze preferencí studenta, ale logickým důsledkem povahy oboru a typu literatury.
3.4 Konkrétní scénáře z praxe
Volbu nástroje lze dobře ilustrovat na několika typických příkladech z běžného života. Student, který píše krátkou seminární práci na poslední chvíli, pravděpodobně zvolí GS, převáží rychlost a jednoduchost práce nad kvalitou zdrojů. Student, který píše rozsáhlejší odbornou práci nebo připravuje systematickou rešerši, naopak sáhne po knihovních databázích, protože potřebuje přesně strukturované výsledky s možností filtrování a přesnou reprodukovatelností výsledků. Student humanitního zaměření může dostávat více relevantních výsledků právě díky širšímu pokrytí GS, zatímco student technických oborů zjistí, že přesnější výsledky najde v databázích jako Web of Science či Scopus. Tento vzorec volby potvrzují i studie Colón-Aguirre (2019) a Howland a spol. (2009), které ukazují, že studenti se rozhodují především podle aktuální potřeby, zkušeností a prostředí, ve kterém pracují.
3.5 Vlastní zkušenost
Má vlastní zkušenost z psaní této seminární práce odpovídá uvedeným scénářům. V úvodní fázi jsem téma zkoumala převážně prostřednictvím GS, kde jsem si rychle „osahala“ základní pojmy a vybrala články, které byly nejvíce citované (i když při psaní této práce jsem zjistila, že ne vždy uvedené číslo odpovídá realitě). Ve chvíli, kdy jsem potřebovala přesná data o pokrytí oborů, ukázaly se jako užitečnější knihovní databáze (zejména Scopus a Web of Science dostupné přes knihovnu VŠE). Prakticky to znamenalo, že jsem část záznamů našla přes GS, ale finální seznam literatury i citace jsem ověřovala v databázích.
4 Vývoj významu knihovních databází v éře snadno dostupných vyhledávačů
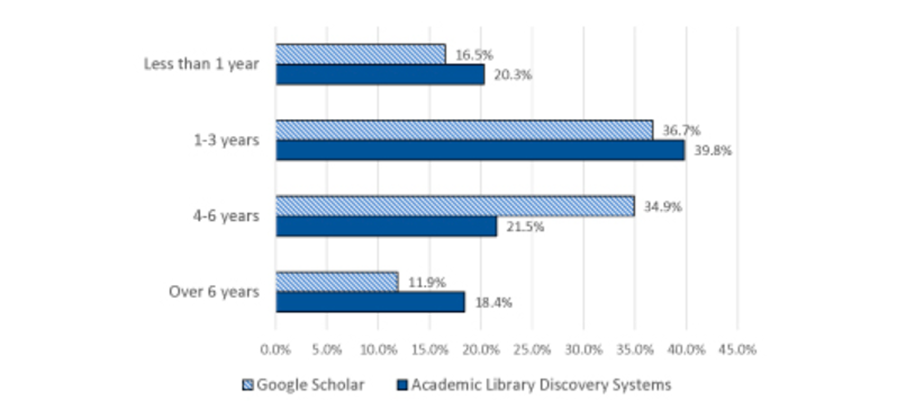
Dostupné studie často uvádějí, že knihovní databáze jsou pro méně zkušené uživatele hůře ovladatelné, příliš komplexní a nepřehledné (např. Howland et al., 2009; Arendt, 2008). Data ze studie Colón-Aguirre (2019) tento obecně přijímaný předpoklad ovšem do značné míry vyvracejí. Její výsledky ukazují, že začínající uživatelé (méně než 1 rok) i uživatelé s praxí 1–3 roky dávají přednost knihovním databázím, a ne GS. To znamená, že noví uživatelé se knihovních databází nebojí a naopak aktivně preferují, což je v přímém rozporu s domněnkou, že knihovní databáze jsou „pro začátečníky nevhodné“. Tento výsledek naznačuje, že intuitivnost nástrojů není dána jen uživatelským rozhraním, ale také kontextem, ve kterém je studenti využívají – například na základě doporučení vyučujících a institucionálních návyků.
Zlom nastává u skupiny studentů s praxí 4–6 let, kde jednoznačně dominuje GS. Tato skupina jej využívá výrazně častěji než databáze, což může souviset s tím, že po určité době začínají studenti oceňovat rychlost, dostupnost a pohodlí GS.
Zajímavý trend nastává u nejzkušenějších uživatelů (6+ let), kde se preference opět obrací ve prospěch knihovních databází. Ty jsou pravděpodobně preferované díky přesným metadatům a možnosti odborné filtrace.
Frekvence používání (Obrázek 2) navíc ukazuje, jak rozdílné role oba nástroje v praxi plní. GS se objevuje mnohem častěji v kategorii „irregularly“, což může naznačovat, že jej studenti používají zejména při méně náročných nebo časově omezených úkolech, například běžných seminárních pracích, kde hraje roli rychlé dohledání základních zdrojů, nikoli systematická rešerše.
Naopak knihovní databáze mají výrazně vyšší zastoupení v kategorii „weekly“, což naznačuje, že studenti je používají tehdy, když pracují na rozsáhlejších nebo důležitějších projektech, např. diplomových pracích nebo rešerších. To odpovídá závěrům Howlanda et al. (2009) či Arendt (2008), kteří zdůrazňují význam tradičních databází zejména při akademické, přesné a kvalitně podložené práci.

Závěr
Cílem této práce bylo porovnat Google Scholar a knihovní databáze z hlediska jejich vlastností, způsobu použití a faktorů ovlivňujících preferenci studentů. Z komparativní analýzy dostupných studií i vlastní zkušenosti vyplývá, že oba nástroje mají své místo a nedokážou jeden druhý plně nahradit. Každý slouží k jinému účelu, studenti tedy nástroj vybírají podle situace.
Google Scholar představuje pro většinu studentů první volbu hlavně proto, že je dobře přístupný, jednoduchý a rychlý. Jeho velká výhoda je nepřeberné množství zdrojů, které zahrnuje i šedou literaturu. V tomto případě je třeba zmínit i slabou stránku dostupnosti šedé literatury, a to nekonzistenci výsledků, nepřesnost citací a možný výskyt duplicit (zmiňován především ve starších studiích). Jedná se tedy o skvělý nástroj pro základní přehled o tématu, na systematickou rešerši však nestačí.
Naopak knihovní databáze fungují na principu zcela opačném. Netolerují nepřesné dotazy či vágní formulace, vyžadují práci s filtry a strukturou vyhledávání, ale nabízejí přesnost, spolehlivost a možnost reprodukovatelnosti výsledků, což je při psaní rozsáhlých odborných prací zcela klíčové. Mezi nevýhody patří menší pokrytí některých oblastí a také omezená dostupnost veřejnosti mimo akademickou sféru. Pokud ovšem student potřebuje zdroj se zárukou kvality či přesná metadata, bez knihovních databází se většinou neobejde.
Za překvapení považuji skutečnost, že studie neukazují tak jednoduchý vzorec, jak bychom mohli očekávat. Nezkušení uživatelé se knihovních databází nebojí, spíš naopak, jelikož se s nimi často setkají díky vyučujícím. Teprve studenti s delší praxí začínají preferovat Google Scholar, aby se pak ti nejzkušenější opět vraceli ke knihovním databázím – tentokrát zcela vědomě, protože empirickou praxí zjistili, že pouze na GS se spolehnout nedá.
Moje vlastní zkušenost to potvrzuje. Na začátku jsem dala přednost GS, protože jsem se ve zvoleném tématu potřebovala rychle zorientovat, jakmile však došlo na přesné údaje nebo jednoduchou filtraci, byla jsem nucena sáhnout po knihovních databázích, které tenhle typ informací poskytují spolehlivěji.
Nemůžeme tedy dojít k závěru, že by knihovní databáze ztrácely význam, spíš se mění a vyvíjí způsob jejich využití. Google Scholar můžeme s jistotou označit za skvělý startovní bod a nástroj na rychlé dohledávání. Knihovní databáze pak fungují jako záruka kvality, přesnosti a reprodukovatelnosti. Za ideální by se dala považovat kombinace obojího — a právě to se zdá být i reálnou praxí většiny studentů.
Použitá literatura
Arendt, J., 2008. Imperfect tools: Google Scholar vs. traditional commercial library databases. Library Hi Tech News, 25(9); pp.26-30.
Gusenbauer, M. & Haddaway, N.R., 2020. What every researcher should know about searching: Science, systematic searching and beyond. Research Synthesis Methods, 11(2), pp.136–147.
Colón-Aguirre, M., 2019. A comparative study of perceptions and use of Google Scholar and academic library discovery systems. College & Research Libraries News, 80(6), pp.876–891.
Haddaway, N.R., Collins, A.M., Coughlin, D. & Kirk, S., 2015. The role of Google Scholar in evidence reviews and its applicability to grey literature searching. PLoS ONE, 10(9), pp.1-17.
Howland, J.L., Wright, T.C., Boughan, R.A. & Roberts, B.C., 2009. How scholarly is Google Scholar? A comparison to library databases. College & Research Libraries, 70(3), pp.227–234.
Jacsó, P., 2005. Google Scholar: the pros and the cons. Online Information Review, 29(2), pp.208–214.
Regis College Library, bez data. Why use library databases? Dostupné z: https://libguides.regiscollege.edu/researchintro/whydatabase [Citováno 27. 11. 2025]
Levine-Clark, M. & Gil, E.L., 2021. A new comparative citation analysis: Google Scholar, Microsoft Academic, Scopus, and Web of Science. Journal of Electronic Resources Librarianship, 26(1–2), pp.145–163.
Houshyar, M. & Sotudeh, H., 2018. A reflection on the applicability of Google Scholar as a tool for comprehensive retrieval in bibliometric research and systematic reviews. International Journal of Information Science and Management, 16(2), pp.1–17.